系统要求
网络要求
当使用 Kafka 作为采集代理的目的地时,需要为 Kafka producer 配置相应的连接信息。
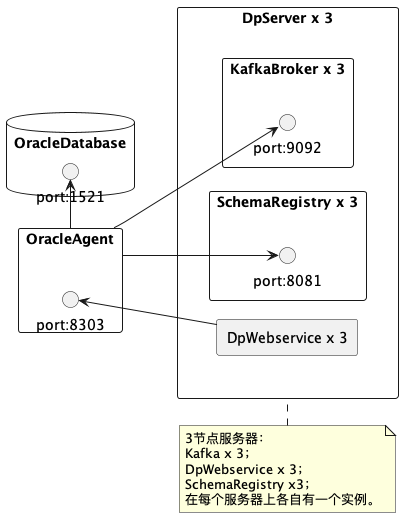
- 须编辑部署所在服务器 /etc/hosts 做 kafka1,kafka2,kafka3 的对应域名-IP 映射。具体参照 Kafka输出配置
- 须访问 DataPipeline Kafka、Schema Registry 所在服务器的 9092(Kafka Borker 端口)和 8081 端口(Schema Registry 端口)。
- 须被 DataPipeline DpThrallWebService 所在服务器访问 8303 端口。(端口号在 param.yml 中可配置,默认为 8303)。
内存要求
采集代理程序运行在 JVM 中,系统剩余内存至少2G 以上。程序内存使用限制参考 内存限制。
磁盘要求
磁盘使用量主要组成为 1. 超过程序限定输出内存大小(param/out_mb)的事务解析后存储在本地的缓存文件,和数据库大事务行为有关。 2. 程序运行日志(固定大小,固定回收,通过配置 log4j.properties 文件指定单个大小和回收策略,默认单个文件 10M,30个文件) 与 DML 数据相关的文件在输出到 Kafka 后会自动删除回收。
程序默认当前磁盘量少于 ( min_diskspace 默认 10G ) 后会报错磁盘空间不足的错误,并停止解析。间隔 ( retry_backoff_ms 默认 10000 ) 毫秒后自动重启,重新检查是否有足够磁盘空间。
设置磁盘限制方法参考 磁盘限制。
系统设置
最大文件打开数 (ulimit -n )建议设置为 65535。
系统用户
如果是本地部署,且安装启动采集代理的系统用户非 root 或 oracle 用户,由于程序需要对数据库本地的日志文件有读权限,该用户需加入 oracle 用户所在的用户组中。 所有采集代理 oragent 文件夹下的变更执行操作(启停,编辑配置文件)等都必须在改用户下。 注意不得以其他用户执行或修改运行目录下的文件。
$ useradd [用户名] -d [home目录,一般会在 /data 这种磁盘上] # 创建一个用户
$ groups oracle # 得到 oracle 用户所在用户组。可有多个。
oracle : oinstall dba pip install mkdocs-material
# 上面命令的返回结果
$ usermod -a -G oinstall,dba [用户名] # 将 【用户名】加入 -G 后面用逗号分隔的用户组中。